前面研究過 Tavily Search API,可以讓自己的 Web Agent 直接搜尋網路
後來翻了一下官方文件,發現 Tavily 還有 Extract API,可以直接讀取網頁內容,再轉成 Markdown 給 LLM 使用
這功能跟之前介紹的 Jina Reader 很像,不過 Tavily 還有個 Keyless 模式,不用註冊、不用 API Key,也不用綁信用卡
這個就有點意思了,這次直接用 C# HttpClient 來試試看
1. Tavily Extract + Keyless 是什麼?
Extract 就是給它一個 URL,讓 Tavily 幫你擷取網頁內容,整理成 Markdown 或純文字
一般使用 Tavily API 需要 API Key,但官方現在提供 Keyless 模式,只要帶上指定的 Header,就能直接使用 Search 和 Extract
翻了一下官方文件與 SDK 原始碼,Keyless 模式的限制整理如下:
| 項目 | Keyless |
|---|---|
| 註冊帳號 | 不需要 |
| API Key | 不需要 |
| 信用卡 | 不需要 |
| Search / Extract | 支援 |
| Crawl / Map / Research | 不支援 |
| 免費限制 | 共享 Rate Limit |
| 固定免費額度 | 官方沒有保證具體次數 |
所以 Keyless 不是無限免費,只是省掉申請 API Key 的流程,對自己開發 Agent 測試來說滿方便的
官方 GitHub:tavily-ai/tavily-python
2. C# 使用 HttpClient 呼叫 Extract
這次一樣使用 .NET 10,不需要安裝任何 SDK
Endpoint:
POST https://api.tavily.com/extract跟一般 API 最大的差別,就是不需要 Authorization,只要加上:
X-Tavily-Access-Mode: keyless這個 Header 在 Tavily 官方 Python SDK 跟 MCP 原始碼都能找到
C# Code:
using System.Net.Http.Json;
using System.Text.Json;

namespace AgentSearchTest
{
    internal class TavilyExtractTest
    {
        public static async Task RunAsync()
        {
            using var http = new HttpClient
            {
                Timeout = TimeSpan.FromSeconds(60)
            };

            http.DefaultRequestHeaders.Add(
                "X-Tavily-Access-Mode", "keyless");

            http.DefaultRequestHeaders.Add(
                "X-Client-Source", "csharp-extract-demo");

            var request = new
            {
                urls = "https://donmalab.com/articles/ai-edge-agent-llm-202604301441",
                extract_depth = "basic",
                format = "markdown"
            };

            using var response = await http.PostAsJsonAsync(
                "https://api.tavily.com/extract",
                request);

            var body = await response.Content.ReadAsStringAsync();

            if (!response.IsSuccessStatusCode)
            {
                Console.WriteLine($"HTTP {(int)response.StatusCode}");
                Console.WriteLine(body);
                return;
            }

            using var json = JsonDocument.Parse(body);
            var root = json.RootElement;

            foreach (var item in root.GetProperty("results").EnumerateArray())
            {
                var url = item.GetProperty("url").GetString();
                var content = item.GetProperty("raw_content").GetString();

                Console.WriteLine($"URL: {url}");
                Console.WriteLine(content);
            }

            if (root.TryGetProperty("failed_results", out var failed))
            {
                foreach (var item in failed.EnumerateArray())
                {
                    Console.WriteLine($"Failed: {item}");
                }
            }
        }
    }
}
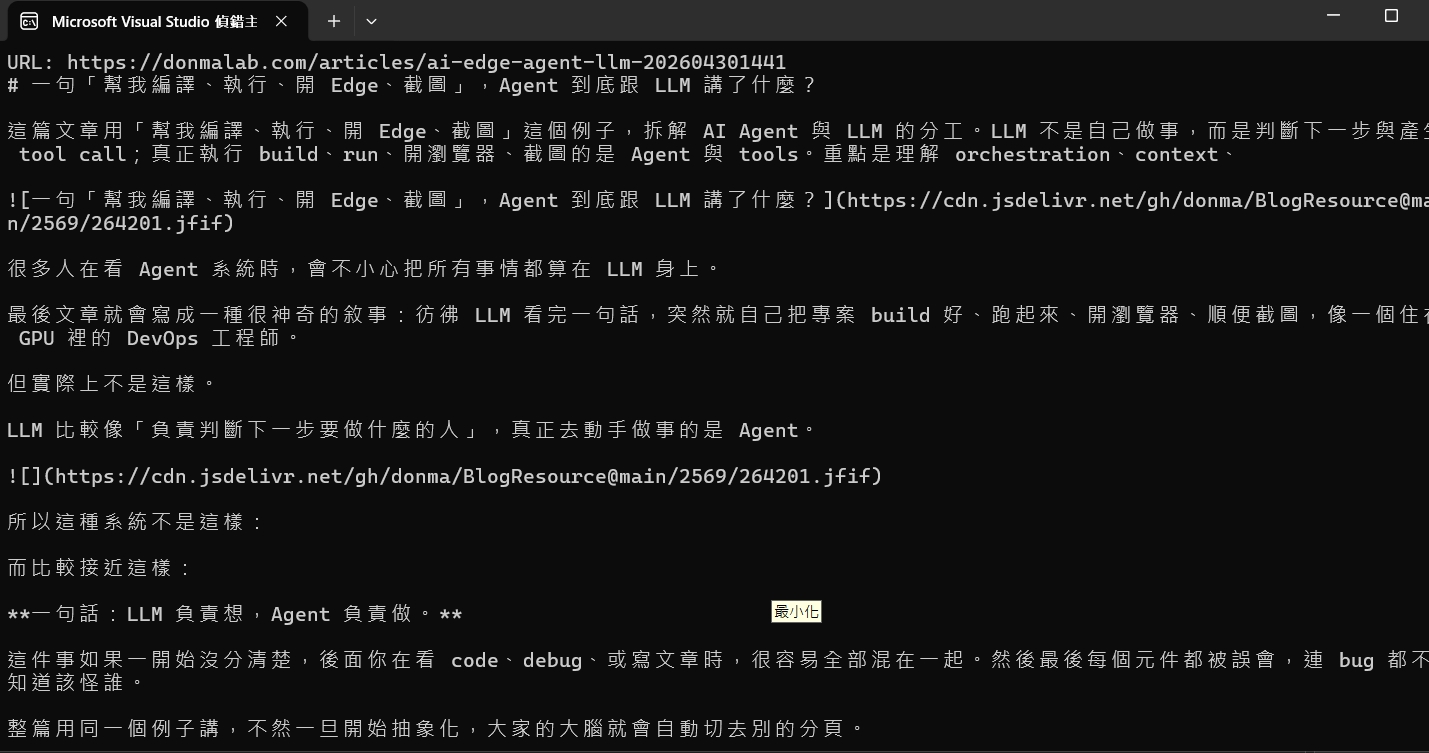
這次直接拿自己的文章網址來測,主要看回傳的 raw_content,也就是 Tavily 整理後的網頁內容
指定 format = "markdown",就能要求輸出 Markdown,不用自己處理 HTML Tag
另外,像是某些網站有防爬蟲機制、網頁存取失敗,或者 Tavily 沒辦法正常解析內容,就可能出現在 failed_results
如果整個 Keyless 請求撞到 Rate Limit,則要直接處理 API 錯誤,而不是只看 failed_results
3. Extract 跟 Jina Reader 有什麼不同?
之前介紹過 Jina Reader,也是一樣透過 URL 直接把網頁轉成 Markdown
兩個工具都能無 Key 抓取 Markdown,但呼叫方式還是有點差異,我順手叫 GPT 幫我拉個對照表 :
| 項目 | Tavily Extract | Jina Reader |
|---|---|---|
| 呼叫方式 | POST JSON | GET 網址前綴 |
| 多網址 | 單次可指定多筆 | 通常逐筆呼叫 |
| 擷取深度 | basic / advanced | 沒有相同參數 |
| Markdown | 支援 | 支援 |
| 免費限制 | Keyless 共享額度 | 無 Key 有 RPM 限制 |
Jina Reader 可以直接使用 https://r.jina.ai/https://example.com 讀取網頁,寫法比較簡單
Tavily Extract 則可以在一次 Request 裡面放多個 URL,而且有 extract_depth 可以選擇
如果只是一般 Web Fetch,我覺得兩個都可以留著當備援,實際哪個抓得比較完整,還是得拿相同網頁來比較
4. Keyless 遇到 Rate Limit 怎麼辦?
Keyless 走的是官方共享額度,所以不能期待它一直都能使用
如果請求太頻繁,API 可能回傳:
429 Too Many Requests官方 SDK 也有處理 Keyless 專用的錯誤資訊,例如 retry_after_seconds,可以用來判斷建議等待多久,但不是每次都保證有這個欄位或 HTTP
Retry-After Header
這邊我自己會直接做 Fallback:
web_fetch
   |
   +-- Tavily Extract Keyless
   |
   +-- Jina Reader
   |
   +-- Tavily Extract API Key
Keyless 失敗就換下一個 Provider,不用讓整個 Agent 一直卡在同一個 API
正式環境還是要加 Timeout、Cache 跟 Rate Limit 控制,避免同一個網址被反覆抓取
簡單說個結論
Tavily 除了 Search,Extract 也可以直接拿來做 Agent 的 Web Fetch,而且 Keyless 不需要 API Key,對開發測試來說確實方便
我自己應該會把 Tavily Extract 跟 Jina Reader 都放進 Web Fetch Provider,哪個失敗就換另外一個
目前先把 C# 呼叫方式記錄下來,如果你要開發 Agent 要做 Web fetch 多一手備份總是好事..
reference:
--
Before you read this, the article was in a superposition of human and AI. Upon observation, the wave function collapsed into a sleep-deprived developer.
如果這篇文章有幫助到您幫我分享一下,讓我有寫下去的動力...